智能体框架二:LangGraph
LangGraph 作为 LangChain 生态系统的重要扩展,代表了智能体框架设计的一个全新方向。与前面介绍的基于“对话”的框架(如 AutoGen 和 CAMEL)不同,LangGraph 将智能体的执行流程建模为一种状态机(State Machine),并将其表示为有向图(Directed Graph)。在这种范式中,图的节点(Nodes)代表一个具体的计算步骤(如调用 LLM、执行工具),而边(Edges)则定义了从一个节点到另一个节点的跳转逻辑。这种设计的革命性之处在于它天然支持循环,使得构建能够进行迭代、反思和自我修正的复杂智能体工作流变得前所未有的直观和简单。
要理解 LangGraph,我们需要先掌握它的三个基本构成要素。
首先,是全局状态(State)。整个图的执行过程都围绕一个共享的状态对象进行。这个状态通常被定义为一个 Python 的 TypedDict,它可以包含任何你需要追踪的信息,如对话历史、中间结果、迭代次数等。所有的节点都能读取和更新这个中心状态。
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages

class SearchState(TypedDict):
    messages: Annotated[list, add_messages]
    user_query: str      # 经过LLM理解后的用户需求总结
    search_query: str    # 优化后用于Tavily API的搜索查询
    search_results: str  # Tavily搜索返回的结果
    final_answer: str    # 最终生成的答案
step: str # 标记当前步骤其次,是节点(Nodes)。每个节点都是一个接收当前状态作为输入、并返回一个更新后的状态作为输出的 Python 函数。节点是执行具体工作的单元。
from store import SearchState;
from utils import llm, tavily_client;
from langchain_core.messages import AIMessage, SystemMessage;

# 理解节点
def understand_query_node(state: SearchState) -> SearchState:
    """步骤1:理解用户查询并生成搜索关键词"""
    user_message = state["messages"][-1].content

    understand_prompt = f"""分析用户的查询:"{user_message}"
请完成两个任务:
1. 简洁总结用户想要了解什么
2. 生成最适合搜索引擎的关键词(中英文均可,要精准)

格式:
理解:[用户需求总结]
搜索词:[最佳搜索关键词]"""

    response = llm.invoke([SystemMessage(content=understand_prompt)])
    response_text = response.content

    # 解析LLM的输出,提取搜索关键词
    search_query = user_message # 默认使用原始查询
    if "搜索词:" in response_text:
        search_query = response_text.split("搜索词:")[1].strip()

    return {
        "user_query": response_text,
        "search_query": search_query,
        "step": "understood",
        "messages": [AIMessage(content=f"我将为您搜索:{search_query}")]
    }

# 搜索节点
def tavily_search_node(state: SearchState) -> dict:
    """步骤2:使用Tavily API进行真实搜索"""
    search_query = state["search_query"]
    try:
        print(f"🔍 正在搜索: {search_query}")
        response = tavily_client.search(
            query=search_query, search_depth="basic", max_results=5, include_answer=True
        )

        results = response.get("results", [])
        formatted_results = []
        for item in results:
            title = item.get("title", "")
            url = item.get("url", "")
            content = item.get("content", "")
            formatted_results.append(f"- {title}\n  {url}\n  {content[:300]}...")

        answer = response.get("answer", "")
        if answer:
            search_results = answer + "\n\n---\n\n" + "\n\n".join(formatted_results)
        else:
            search_results = "\n\n".join(formatted_results) if formatted_results else "未检索到相关结果。"

        return {
            "search_results": search_results,
            "step": "searched",
            "messages": [AIMessage(content="✅ 搜索完成!正在整理答案...")]
        }
    except Exception as e:
        return {
            "search_results": f"搜索失败:{e}",
            "step": "search_failed",
            "messages": [AIMessage(content="❌ 搜索遇到问题...")]
        }

# 生成节点
def generate_answer_node(state: SearchState) -> dict:
    """步骤3:基于搜索结果生成最终答案"""
    if state["step"] == "search_failed":
        # 如果搜索失败,执行回退策略,基于LLM自身知识回答
        fallback_prompt = f"搜索API暂时不可用,请基于您的知识回答用户的问题:\n用户问题:{state['user_query']}"
        response = llm.invoke([SystemMessage(content=fallback_prompt)])
    else:
        # 搜索成功,基于搜索结果生成答案
        answer_prompt = f"""基于以下搜索结果为用户提供完整、准确的答案:
用户问题:{state['user_query']}
搜索结果:\n{state['search_results']}
请综合搜索结果,提供准确、有用的回答..."""
        response = llm.invoke([SystemMessage(content=answer_prompt)])

    return {
        "final_answer": response.content,
        "step": "completed",
        "messages": [AIMessage(content=response.content)]
    }
构建图:
def create_search_assistant():
    workflow = StateGraph(SearchState)

    # 添加节点
    workflow.add_node("understand", understand_query_node)
    workflow.add_node("search", tavily_search_node)
    workflow.add_node("answer", generate_answer_node)

    # 设置线性流程
    workflow.add_edge(START, "understand")
    workflow.add_edge("understand", "search")
    workflow.add_edge("search", "answer")
    workflow.add_edge("answer", END)

    # 编译图
    memory = InMemorySaver()
    app = workflow.compile(checkpointer=memory)
    return app
运行案例展示:
运行此脚本后,您可以提出一些需要实时信息的问题,例如我们第一章中的案例:明天我要去北京,天气怎么样?有合适的景点吗
您会看到终端清晰地展示出智能体的“思考”过程:
if __name__ == '__main__':
    myApp = create_search_assistant()
    # 运行图
    inputs = {
        "messages": [HumanMessage(content="明天我要去北京,天气怎么样?有合适的景点吗")]
    }
    config = {"configurable": {"thread_id": "demo-thread-1"}}
    for event in myApp.stream(inputs, config=config):
        print(event)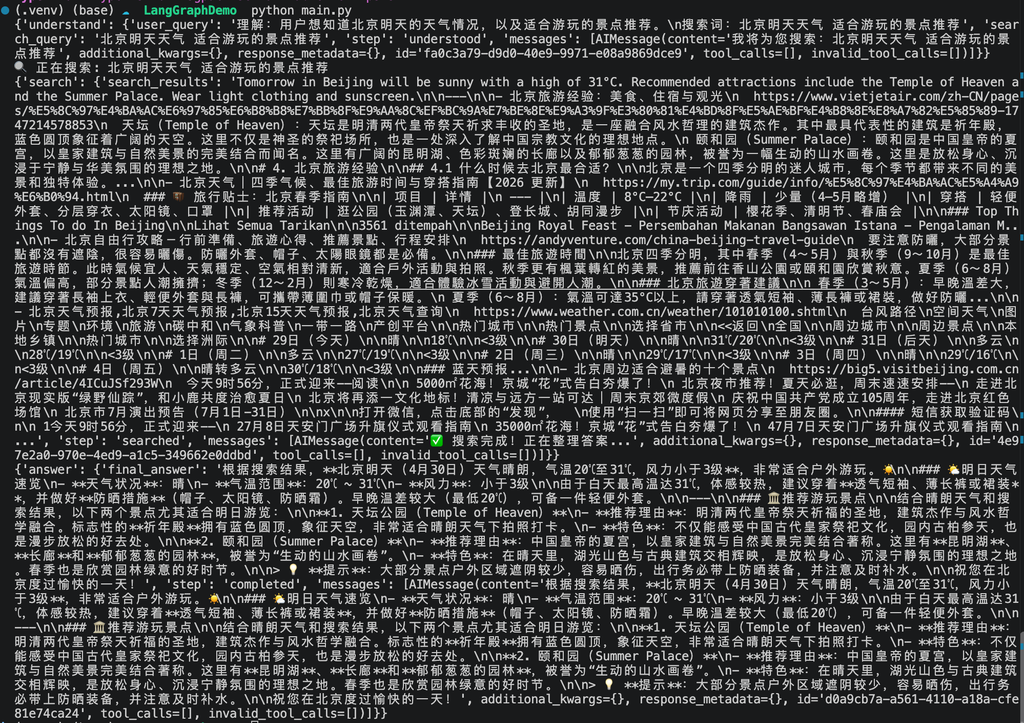
任何技术框架都有其特定的适用场景和设计权衡。在本节中,我们将客观地分析 LangGraph 的核心优势及其在实际应用中可能面临的局限性。
(1)优势
- 如我们的智能搜索助手案例所示,LangGraph 将一个完整的实时问答流程,显式地定义为一个由状态、节点和边构成的“流程图”。这种设计的最大优势是高度的可控性与可预测性。开发者可以精确地规划智能体的每一步行为,这对于构建需要高可靠性和可审计性的生产级应用至关重要。其最强大的特性在于对循环(Cycles)的原生支持。通过条件边,我们可以轻松构建“反思-修正”循环,例如在我们的案例中,如果搜索失败,可以设计一个回退到备用方案的路径。这是构建能够自我优化和具备容错能力的智能体的关键。
- 此外,由于每个节点都是一个独立的 Python 函数,这带来了高度的模块化。同时,在流程中插入一个等待人类审核的节点也变得非常直接,为实现可靠的“人机协作”(Human-in-the-loop)提供了坚实的基础。
(2)局限性
- 与基于对话的框架相比,LangGraph 需要开发者编写更多的前期代码(Boilerplate)。定义状态、节点、边等一系列操作,使得对于简单任务而言,开发过程显得更为繁琐。开发者需要更多地思考“如何控制流程(how)”,而不仅仅是“做什么(what)”。由于工作流是预先定义的,LangGraph 的行为虽然可控,但也缺少了对话式智能体那种动态的、“涌现”式的交互。它的强项在于执行一个确定的、可靠的流程,而非模拟开放式的、不可预测的社会性协作。
- 调试过程同样存在挑战。虽然流程比对话历史更清晰,但问题可能出在多个环节:某个节点内部的逻辑错误、在节点间传递的状态数据发生异变,或是边跳转的条件判断失误。这要求开发者对整个图的运行机制有全局性的理解。